Yapay zekada sentetik veri, gerçek verilere benzer özellikler taşıyan fakat laboratuvar ortamında üretilen verilerdir. Bu yazıda, sentetik verinin ne olduğunu, yapay veri üretiminin nasıl gerçekleştiğini, AI eğitim verisinde nasıl kullanıldığını ve sentetik veri kalitesinin önemini öğreneceksiniz. Sentetik veri, özellikle sınırlı veya gizli verilerin bulunduğu durumlarda, yapay zeka modellerinin eğitiminde kritik bir rol oynamaktadır. Gerçek veri setlerinin yetersiz olduğu durumlarda, bu tür veriler modelin başarısını artırmak için mükemmel bir alternatif sunar. Verilerin kalitesi, modelin performansını doğrudan etkilediğinden, sentetik veri kalitesine dikkat etmek son derece önemlidir. Yapay zeka projelerinizde sentetik verileri nasıl kullanabileceğinizi öğrenmek için yazımızı takip edin!
Sentetik Veri Nedir?
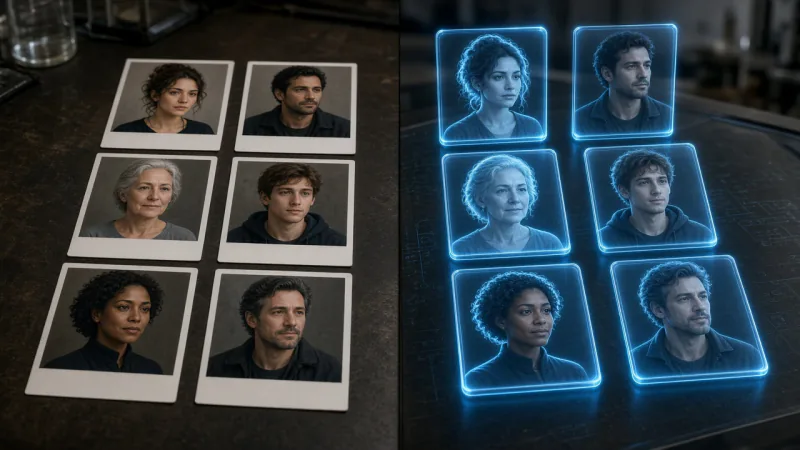
Sentetik veri, gerçek verilerin yerine veya tamamlayıcısı olarak oluşturulan yapay verilerdir. Bu tür veriler, genellikle yapay zeka (AI) sistemlerinin eğitiminde ve test süreçlerinde kullanılır. Sentetik veriler, gerçek dünya verilerinin sınırlamalarını aşmaya yardımcı olurken, aynı zamanda gizlilik endişelerini de azaltır.
Gerçek veriler genellikle sınırlı miktarda veya erişim konusunda zorluklar içerirken, sentetik veriler bu sorunları çözmek için tasarlanmıştır. Yapay veri üretimi, algoritmalar ve modelleme teknikleri kullanılarak gerçekleştirilir. Bu süreç, gerçek verilerin özelliklerini taklit eden yeni veri setleri oluşturmayı mümkün kılar.
Sentetik verilerin en önemli avantajlarından biri, çeşitli senaryoları simüle edebilme yeteneğidir. AI eğitim verisi olarak kullanıldığında, sistemin dayanıklılığı ve genel performansı üzerinde olumlu etkiler yaratır. Bununla birlikte, sentetik verilerin kalitesi, oluşturulma sürecinin doğruluğuna ve modelin etkinliğine bağlıdır.
Sonuç olarak, sentetik veri, günümüzde veri gizliliği, veri çeşitliliği ve eğitim süreçlerinin etkinliği açısından önemli bir rol oynamaktadır. Yapay zeka uygulamalarının başarısını artırmak için kritik bir bileşen haline gelmiştir. Bu nedenle, sentetik verilerin doğru bir şekilde üretilmesi ve kullanılması, AI projelerinin başarısı için hayati öneme sahiptir.
Gerçek Veriden Farkı Nedir?
Sentetik veri, gerçek dünyadaki verilere dayanmadan, yapay olarak oluşturulan verilerdir. Bu tür veriler, genellikle bilgisayar algoritmaları ve simülasyonlar kullanılarak üretilir. Gerçek veriden farkı, doğal ortamlarda toplanmamış olmalarıdır. Bu nedenle, gizlilik ve güvenlik açısından daha az risk taşırlar. Ancak, gerçek verilerle karşılaştırıldığında, sentetik verilerin kalitesi ve geçerliliği önemlidir.
Gerçek verilere dayanan analizler, genellikle belirli bir bağlamda anlam kazanır. Oysa sentetik veriler, belirli senaryoları simüle etmek için oluşturulduğundan, bu tür verilerde bağlam eksikliği olabilir. Bu eksiklik, yapay veri üretimi sürecinde dikkat edilmesi gereken bir faktördür. Verilerin doğruluğu ve güvenilirliği, yapay zeka (AI) eğitim verisi olarak kullanılacaksa kritik bir unsurdur.
Sentetik verilerin bir diğer önemli farkı, önyargı taşıma olasılığıdır. Gerçek veriler, toplumsal önyargıları ve yanlılıkları barındırabilirken, sentetik veriler, bu önyargıların daha kontrollü bir şekilde üretilebilmesine olanak tanır. Ancak, sentetik verilerin oluşturulma sürecinde de önyargı taşınma riski bulunur. Bu nedenle, verilerin üretim süreçlerinin dikkatlice planlanması ve önyargıların minimize edilmesi gerekmektedir.
Sonuç olarak, sentetik veri ile gerçek veri arasındaki farklar, veri analizi ve yapay zeka uygulamalarında önemli bir rol oynamaktadır. Her iki veri türünün de avantajları ve dezavantajları vardır. Özellikle gizlilik ve güvenlik konularında sentetik veriler daha avantajlı iken, gerçek verilerin bağlamı ve geçerliliği, analizlerin sonuçlarını etkileyebilir. Bu dengeyi sağlamak, etkili bir veri kullanımı için hayati öneme sahiptir.
Hangi Amaçlarla Üretilir?
Sentetik veri, birçok farklı amaçla üretilmektedir ve bu verinin kullanımı teknoloji alanında giderek artmaktadır. Öncelikle, yapay zeka (AI) ve makine öğrenimi (ML) uygulamaları için gerekli olan eğitim verisini sağlamak amacıyla kullanılmaktadır. Gerçek veri toplamak her zaman mümkün veya pratik değildir; bu durumda yapay veri üretimi, sistemlerin eğitiminde önemli bir rol oynamaktadır.
Ayrıca, sentetik veri oluşturma, veri gizliliği ve güvenliği açısından da önemli avantajlar sunar. Örneğin, gerçek verilerin kullanımı sırasında ortaya çıkabilecek gizlilik sorunlarının önüne geçmek için, benzer ancak kimlik bilgilerini içermeyen yapay veriler oluşturulabilir. Bu, veri işleme süreçlerinde yasal düzenlemelere uyum sağlamaya yardımcı olur.
Bir diğer önemli kullanım alanı ise veri dengesizliği problemidir. Gerçek veri setlerinde sıkça görülen sınıf dengesizliği, bazı sınıfların diğerlerine oranla çok daha az temsil edilmesi durumunu yaratır. Sentetik veri kullanarak, bu dengesizliği gidermek ve daha dengeli veri setleri oluşturmak mümkündür. Böylece, modelin genel performansı artırılabilir.
Son olarak, sentetik veri, prototip geliştirme ve test süreçlerinde de kullanılmaktadır. Yazılım geliştirme süreçlerinde, gerçek veri kullanmak yerine yapay verilerle testler yapılabilir. Bu, hem zaman hem de maliyet açısından büyük tasarruflar sağlayabilir.
Gizliliği Garanti Eder mi?
Sentetik verinin gizlilik sorunlarına yanıt vermesi, özellikle veri güvenliği açısından oldukça önemli bir konudur. Gerçek veriler, kişisel bilgiler içerebileceği için, bu verilerin korunması büyük bir hassasiyet gerektirir. Ancak sentetik veri, gerçek verilerin özelliklerini taklit eden yapay veriler olarak, kişisel bilgileri barındırmadığı için gizlilik açısından avantaj sunar.
Yapay veri üretimi sırasında, gerçek veriler üzerinde yapılan işlemler sayesinde, bireylerin kimlik bilgileri ve diğer hassas veriler yok edilir. Bu sayede, AI eğitim verisi oluşturulurken, kullanıcıların gizliliği korunmuş olur. Sentetik veriler, yalnızca istatistiksel özellikleri korurken, bireysel verilerin gizliliğini ihlal etmez.
Ancak, gizliliği garanti altına almanın kesin bir yolu yoktur. Eğer sentetik veri oluşturma sürecinde yeterince dikkat edilmezse, bazı durumlarda gerçek verilerden izler taşıyabilir. Bu nedenle, sentetik veri kalitesi ve üretim süreçlerinin titizlikle kontrol edilmesi gereklidir. Güçlü algoritmalar ve doğru yöntemlerle üretildiğinde, sentetik veri sistemi, veri gizliliği açısından yüksek bir güvenlik seviyesi sunabilir.
Sonuç olarak, sentetik verinin gizliliği, doğru bir şekilde üretildiğinde sağlanabilir. Ancak bu süreçte dikkatli olunması ve gerekli önlemlerin alınması hayati öneme sahiptir. Bu sayede, hem veri gizliliği korunur hem de yapay zeka uygulamaları için gerekli veri setleri oluşturulabilir.
Önyargı Nasıl Taşınır?
Yapay zeka uygulamalarında kullanılan sentetik veri, verilerin oluşturulmasında dikkat edilmesi gereken birçok faktörü barındırır. Bu veriler, özellikle gerçek dünyadaki verilerde mevcut olan önyargıları taşıma potansiyeline sahiptir. Önyargılar, verilerin toplandığı kaynaklardan kaynaklanabilir; bu da yapay zeka sistemlerinin taraflı sonuçlar üretmesine neden olabilir.
Önyargıların taşınmasının önlenmesi, yapay veri üretimi sürecinin kritik bir parçasıdır. Verilerin üretimi sırasında, bu önyargıların farkında olmak ve onları minimize etmek için özel yöntemler kullanılmalıdır. Aksi takdirde, yapay zeka modelleri, gerçek dünyadaki adalet ve eşitlik ilkelerini ihlal edebilir.
Bir diğer önemli nokta ise sentetik veri kalitesidir. Kaliteli sentetik veriler, gerçek verilerin çeşitliliğini ve temsil yeteneğini yansıtmalıdır. Bunun için, verilerin üretiminde kullanılan algoritmaların ve yöntemlerin doğruluğu büyük bir etkiye sahiptir. Örneğin, eğer algoritma belirli bir gruptan gelen verileri fazla temsil ediyorsa, o grup hakkında önyargılı bir model ortaya çıkabilir.
Yapılan araştırmalar, önyargıların yapay zeka sistemlerine nasıl entegre olduğu konusunda önemli veriler sağlamıştır. Bu tür analizler, verilerin nasıl toplandığı ve işlendiği üzerine odaklanarak, gelecekteki önyargıların önüne geçilmesine yardımcı olabilir. Verilerin kaynakları ve toplama yöntemleri, bu önyargıların doğrudan etkileyen faktörlerdir.
Sonuç olarak, AI eğitim verisi olarak kullanılan sentetik verilerin dikkatli bir şekilde üretilmesi ve yönetilmesi gerekmektedir. Önyargıların taşınmaması için gerekli önlemler alınmalı ve veri kalitesi sürekli olarak kontrol edilmelidir. Böylece, daha adil ve tarafsız yapay zeka sistemlerinin geliştirilmesi sağlanabilir.
Gerçek Veriyle Benzerlik Nasıl Ölçülür?
Sentetik veri, gerçek verilerin özelliklerini taklit eden, ancak gerçek dünyadaki olayları veya nesneleri temsil etmeyen yapay veridir. Bu verilerin kalitesi, gerçek verilerle olan benzerlikleri ile ölçülmektedir. Benzerliği değerlendirmek için çeşitli yöntemler ve metrikler kullanılabilir. Bu metrikler, verinin yapısal özellikleri, dağılımları ve ilişkinin doğası gibi unsurlara dayanır.
Birinci adım, sentetik veri ile gerçek veri arasındaki temel özelliklerin karşılaştırılmasıdır. Örneğin, her iki veri setinin ortalamaları, varyansları ve dağılım şekilleri incelenebilir. Eğer bu temel istatistikler benzerlik gösteriyorsa, veri setlerinin benzerliği yüksek kabul edilebilir.
İkinci bir yöntem, daha karmaşık algoritmalar kullanarak benzerliği ölçmektir. Yapay zeka ve makine öğrenimi teknikleri, iki veri seti arasındaki korelasyonu belirlemek için kullanılabilir. Örneğin, bir regresyon analizi veya sınıflandırma algoritması kullanarak, gerçek verinin bir modelini oluşturup bu modelin sentetik veride ne kadar başarılı olduğunu değerlendirmek mümkündür.
Ayrıca, görsel analizler de güçlü bir araçtır. Veri dağılımlarını grafikler üzerinde görselleştirerek, iki veri setinin örtüşümünü incelemek, benzerlikleri belirlemede etkili bir yöntemdir. Bu tür görselleştirmeler, verinin nasıl davrandığını ve hangi özelliklerin benzer olduğunu daha net bir şekilde ortaya koyar.
Sonuç olarak, sentetik veri ile gerçek veri arasındaki benzerlikleri ölçmek için istatistiksel karşılaştırmalar, makine öğrenimi teknikleri ve görsel analiz yöntemleri bir arada kullanılmalıdır. Bu yöntemler, yapay verinin kalitesini ve geçerliliğini belirlemede kritik rol oynamaktadır.
Sentetik Verinin Kaynağı Nasıl Belgelenir?
Sentetik veri, gerçek verilerin yerine kullanılan yapay veriler olarak tanımlanabilir. Bu verilerin kaynağının belgelenmesi, özellikle yapay veri üretimi süreçlerinde kritik bir öneme sahiptir. Belgelenmiş bir kaynak, verinin doğruluğunu ve güvenilirliğini artırarak, yapay zeka (AI) eğitim verisi oluşturulmasında önemli bir rol oynar.
Öncelikle, sentetik veri üretim sürecinde kullanılan algoritmalar ve yöntemler açıkça tanımlanmalıdır. Bu, geliştiricilerin ve araştırmacıların nasıl bir veri seti oluşturduğunu anlamalarına yardımcı olur. Örneğin, kullanılan modelin türü, eğitim süreci ve parametreler gibi bilgiler, verinin kaynağını belgelemek için gereklidir.
Bir diğer önemli nokta, yaratılan verinin kalitesinin nasıl kontrol edileceğidir. Sentetik veri kalitesi, gerçek verilerle karşılaştırılarak değerlendirilebilir. Bu karşılaştırma, verinin hangi ölçütlere göre oluşturulduğunu ve ne kadar gerçekçi olduğunu gösterir. Yüksek kaliteli veriler, daha etkili AI sistemleri geliştirilmesine olanak tanır.
Gizlilik konusunda da dikkatli olunmalıdır. Yapay zeka uygulamalarında kullanılan verilerin, kişisel bilgileri içermemesi gerekir. Bu doğrultuda, yapay veri üretimi sürecinde hangi verilerin kullanıldığı ve bu verilerin nasıl anonimleştirildiği hakkında detaylı bilgi sağlanmalıdır.
Son olarak, verinin kaynağının belgelenmesi, etik açıdan da önem taşır. Araştırmacılar ve geliştiriciler, kullandıkları verilerin kökenine dair şeffaf olmalılar. Bu, güvenilirlik oluşturur ve yapay zeka sistemlerinin kabul görmesini artırır. Böylece, sentetik veri kullanımıyla elde edilen sonuçlar, daha geniş bir topluluk tarafından kabul edilebilir hale gelir.
Kalite Nasıl Kontrol Edilir?
Sentetik veri üretimi, yapay zeka (AI) uygulamalarının verimliliğini artırmak amacıyla oldukça önemli bir süreçtir. Ancak bu verilerin kalitesi, elde edilecek sonuçların doğruluğu ve güvenilirliği açısından kritik bir rol oynar. Kalite kontrol süreci, sentetik verinin doğruluğunu, güvenilirliğini ve geçerliliğini sağlamada temel bir adımdır.
Kalite kontrolü, genellikle birkaç aşamadan oluşur. İlk olarak, üretilen yapay veri üretimi setleri, belirli standartlarla karşılaştırılarak değerlendirilir. Bu aşamada verinin çeşitliliği, tutarlılığı ve gerçek dünya koşullarına uygunluğu göz önünde bulundurulur. Ayrıca, sentetik verinin oluşturulmasında kullanılan algoritmaların performansı da bu süreçte incelenir.
Bir diğer önemli husus ise sentetik veri kalitesi ölçümüdür. Bu ölçüm, genellikle istatistiksel yöntemler ve makine öğrenimi teknikleri ile gerçekleştirilir. Örneğin, sentetik verinin gerçek verilerle benzerliğini değerlendirmek için çeşitli metrikler kullanılır. Bu metrikler, verinin ne kadar gerçekçi olduğunu ve modelin ne kadar doğru sonuçlar üretebileceğini belirlemeye yardımcı olur.
Kalite kontrol süreçlerinde, kullanıcı geri bildirimleri de büyük bir rol oynar. Kullanıcıların deneyimleri, verinin pratikteki uygulanabilirliği hakkında önemli bilgiler sunabilir. Bu nedenle, kullanıcı testleri yapmak ve bu testlerden elde edilen verileri analiz etmek, kalite kontrol sürecinin ayrılmaz bir parçasıdır.
Sonuç olarak, AI eğitim verisi oluşturulurken kalite kontrol süreçlerine büyük önem verilmelidir. Hem teknik hem de kullanıcı odaklı yaklaşımlar, sentetik verinin kalitesini artırmak ve güvenilir sonuçlar elde etmek için gereklidir. Her aşamada dikkatli bir değerlendirme yapılması, yapay zeka uygulamalarının başarısını doğrudan etkileyen bir faktördür.


Bu yazı hakkında görüşlerinizi paylaşın